
Prompt engineering beats trial and error for LLMs
A prompt is a text task combining instruction and context that forces a probabilistic model to generate stable, accurate results immediately. Prompt engineering functions as the necessary discipline for managing these probabilistic models by using task-specific instructions rather than relying on chance or magic phrases Prompt engineering. Changing vague queries into precise commands eliminates the need for iterative guessing. The analysis covers why flexible prompting strategies are critical when models lack inherent memory of previous conversations or external facts not explicitly provided in the input flexible prompting.
Engineering rigor beats theoretical fluff here: specific prompt-based behavior emerges from clear boundary setting rather than secret incantations prompt-based behavior. By understanding that large language models simply predict the next token based on visible context, users can stop treating these tools as oracle and start managing them as deterministic systems driven by high-quality input design.
Промпт-инжиниринг как дисциплина управления вероятностными моделями
Промпт как вероятностный запрос к LLM
Промпт, это входной текст, который модель интерпретирует как начало последовательности токенов для вероятностного продолжения. Большая языковая модель (LLM) не «понимает» задачу в человеческом смысле, а вычисляет наиболее статистически вероятное продолжение на основе обученных весов. Промпт-инжиниринг определяется как навык писать такие задания так, чтобы получать стабильный, точный и пригодный к использованию результат с первого-второго раза, смещая распределение вероятностей в сторону нужного ответа. Модель генерирует ответ токен за токеном, опираясь исключительно на предыдущий контекст. Отсутствие явных инструкций заставляет алгоритм заполнять пробелы общими шаблонами.
Без жестких рамок модель часто галлюцинирует. Технически промпт-инжиниринг стал незаменимой техникой расширения возможностей больших языковых моделей (LLM) и визуально-языковых моделей (VLM), позволяя адаптировать универсальные модели под специфические инженерные задачи без дообучения. Чрезмерная детализация запроса ограничивает творческий потенциал модели там, где требуется вариативность. Избыточная свобода снижает воспроизводимость результата. Операторам необходимо балансировать между строгой структурой и гибкостью, понимая, что модель не помнит предыдущих бесед без явной передачи истории в контексте.
Эволюция от ручного подбора к Prompt Pattern Libraries
Экспериментальный метод проб и ошибок уступает место стандартизированным Prompt Pattern Libraries для масштабируемости. Ранние подходы полагались на интуитивный подбор слов, что часто приводило к нестабильным результатам из-за вероятностной природы генерации токенов. Модель выдумывает факты, когда точный контекст отсутствует, заполняя пробелы статистическими догадками вместо проверенных данных. Современная дисциплина смещается к использованию шаблонов, гарантирующих воспроизводимость через жесткую структуру запроса. Исследователи разрабатывают техники градиентного поиска с триггерными токенами для автоматической генерации эффективных инструкций. Этот сдвиг позволяет инженерам заменять ручную настройку на системное управление входными данными, снижая зависимость от удачи оператора.
| Критерий | Ручной подбор | Pattern Libraries |
| Основа метода | Интуиция и подбор слов | Стандартизированные шаблоны |
| Воспроизводимость | Низкая | Высокая |
| Масштабируемость | Ограничена | Автоматизирована |
| Риск галлюцинаций | Высокий | Снижен контекстом |
Внедрение библиотек паттернов требует пересмотра workflows: вместо редактирования текста операторы теперь курируют наборы правил генерации. Автоматизация создает новую зависимость от качества исходных шаблонов, ошибочный паттерн тиражирует дефекты массово. Инженерам следует инвестировать в валидацию базовых структур, так как они становятся критической инфраструктурой. AI Agents News рекомендует фокусироваться на создании проверенных prompt template архетипов для корпоративных систем.
Архитектура идеального запроса состоит из пяти функциональных блоков
Системный промпт как инструкция верхнего уровня
Системный промпт (system) определяет приоритетные правила игры, задавая роль и тон для всего диалога. В отличие от разовых пользовательских запросов, эта инструкция верхнего уровня остается неизменной, формируя устойчивое поведение модели. Архитектура запроса разделяет статические требования в системный блок, а переменные данные передает в пользовательский контекст. Такое разделение позволяет выносить постоянные ограничения, запрещая галлюцинации или требуя конкретного формата вывода. Модель обрабатывает эти директивы как фундаментальный закон, который нельзя игнорировать даже при противоречивых входных данных.
Инженеры используют этот механизм для калибровки Claude Sonnet 4.6 или GPT-5.5, обеспечивая предсказуемость ответов в production-среде. Если пользовательский промпт пытается нарушить заданные рамки, системная инструкция блокирует нежелательное действие. Отсутствие явного разделения приводит к дрейфу стиля и увеличению количества ошибок при длинной истории переписки.
Однако чрезмерно жесткие системные ограничения могут снизить гибкость модели при решении нестандартных задач. Баланс между строгостью правил и адаптивностью требует точной настройки параметров генерации.
Реализация пяти блоков через API разделение сообщений
API-интеграция требует жесткого распределения Роль, Формат и Ограничения в системный промпт для фиксации поведения. Через API управление становится полностью воспроизводимым, так как статические правила не переписываются при каждой итерации. Инженеры размещают Контекст и Задача в пользовательском сообщении, обеспечивая гибкость обработки конкретных данных. Такая архитектура предотвращает конфликты инструкций, когда новые входные данные противоречат первоначальным настройкам модели.
- Роль: Определите персону, например «Senior Python-разработчик», чтобы калибровать техническую глубину и тон ответа.
- Контекст: Предоставьте все вводные, которые модель не может знать сама: данные, факты, фрагменты кода.
- Задача: Укажите точное действие, используя активные глаголы («напиши», «сравни», «извлеки»), объект и критерий успеха.
- Формат: Задайте структуру вывода (список, JSON, таблица), что критично для интеграций, где ответ парсит код.
- Ограничения: Установите рамки: длина, тон, чего избегать.
Отсутствие блока Контекст заставляет модель додумывать данные, повышая риск логических ошибок. Игнорирование определения Формата часто приводит к многословным объяснениям, ломающим автоматизированные пайплайны парсинга.
Выбор момента для использования роли в промпте зависит от необходимости сохранения состояния между запросами. Если роль меняется динамически, её переносят в пользовательский блок, жертвуя стабильностью тона ради адаптивности. Однако частая смена системных инструкций увеличивает токенный расход и задержки генерации. AI Agents News рекомендует фиксировать роль на уровне системы для производственных сценариев, где предсказуемость важнее вариативности. Модели Claude Sonnet 4.6 и GPT-5.5 строго следуют иерархии, приоритизируя системные директивы над пользовательскими увещеваниями. Правильная сегментация снижает риск галлюцинаций, ограничивая область поиска модели заданными параметрами. Разработчики получают детерминированный вывод, исключая необходимость постобработки ответов скриптами.
Техники few-shot и цепочки рассуждений гарантируют точность генерации
Few-shot и Chain-of-Thought: механизмы калибровки стиля
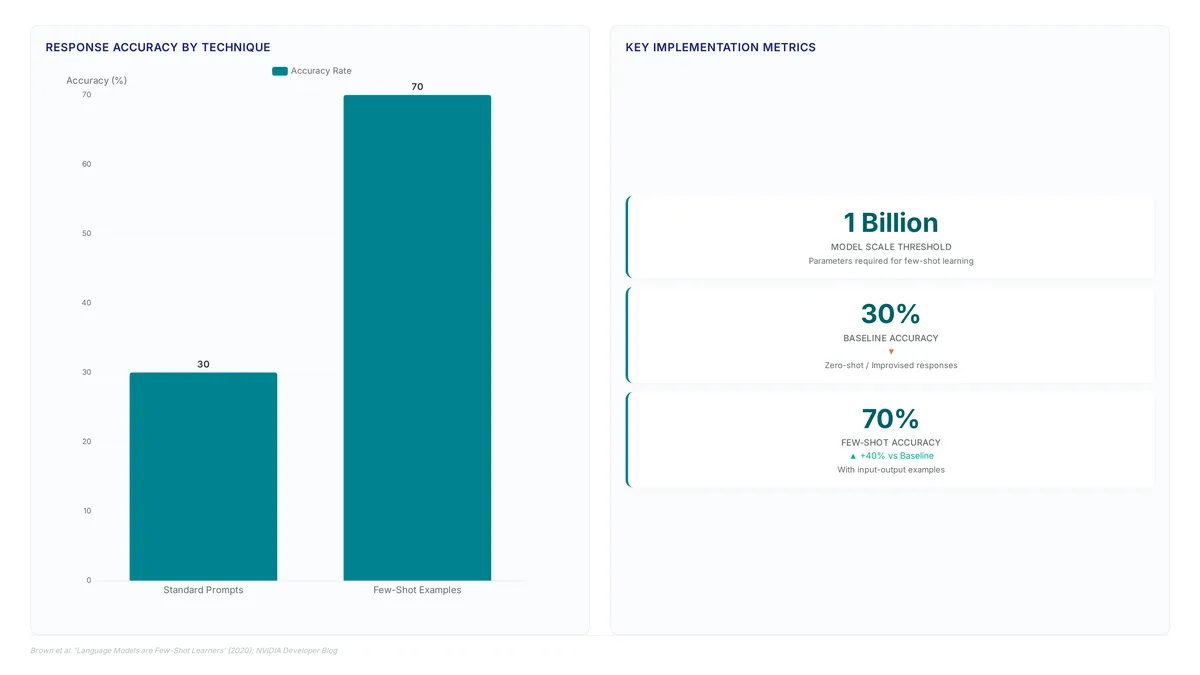
Few-shot подход внедряет несколько пар «вход → выход» для того, чтобы модель улавливала паттерн, что подробно изучено в исследовании Brown et al. «Language Models are Few-Shot Learners» (2020). Этот метод отличается от zero-shot, где модель полагается исключительно на внутренние знания без внешних примеров. Инженеры используют технику для калибровки стиля, когда стандартные инструкции не гарантируют нужного формата ответа. Цепочка рассуждений требует от модели генерировать промежуточные логические шаги перед финальным ответом. Простое добавление фразы «решай шаг за шагом» повышает точность на арифметике и логике. Механизм эффективен для сложных задач, где прямое предсказание токена часто приводит к ошибкам. Выбор между методами зависит от сложности задачи: структурированные промпты улучшают результаты современных моделей, но требуют управления длиной контекста.
Цена few-shot: черновик, итерации и расход токенов
Вместо того чтобы требовать идеальный результат с первой попытки, эффективнее получить черновик и уточнять его через итерации. Промпт-инжиниринг в данном случае описывается как диалог, где каждый шаг сужает пространство возможных ответов модели. Ограничением метода является потребление токенов: каждый пример увеличивает размер контекста и latency. Для задач с жесткими требованиями к задержке или бюджету это создает явный trade-off между точностью и стоимостью inference. Операторам следует взвешивать необходимость множественных примеров против производительности системы.
| Параметр | Few-shot подход | Zero-shot подход |
|---|---|---|
| Примеры в промпте | Несколько пар | Отсутствуют |
| Точность формата | Высокая | Вариабельная |
| Расход токенов | Высокий | Минимальный |
| Сложность настройки | Средняя | Низкая |
Рост токенов и стоимости при пошаговых рассуждениях
Цепочка рассуждений генерирует дополнительные выходные токены, напрямую увеличивая итоговую стоимость генерации. Промежуточные шаги, которые модель обязана прописывать, неизбежно расширяют объем выходных данных. Эффективность подхода подтверждена в исследованиях, где пошаговое мышление улучшило результаты на сложных задачах. Однако операторы сталкиваются с компромиссом между повышением точности и ростом операционных расходов на токены.
| Параметр | Базовый режим | Chain-of-Thought |
| Расход токенов | Минимальный | Высокий |
| Логическая точность | Средняя | Повышенная |
| Стоимость запроса | Низкая | Увеличенная |
Инженерам необходимо взвешивать необходимость глубокой логики для каждого сценария, учитывая, что современные модели становятся более устойчивыми и способны справляться с неоднозначностью при четком framing целей. Гибридный подход позволяет контролировать расходы, сохраняя преимущества метода там, где они действительно нужны. При массовом внедрении агентов важно учитывать, что кратный рост длины ответа существенно влияет на бюджет, требуя внимательного мониторинга использования токенов.
Интеграция промптов через API требует строгого следования протоколу
Настройка API: системный промпт, few-shot и температура
Настройка OpenAI-совместимого endpoint требует явного разделения системных инструкций, примеров few-shot и параметров температуры. Инженеры собирают запрос, передавая role как отдельное системное сообщение для калибровки поведения модели, а не смешивая его с пользовательским контекстом. Для задач, требующих строгого следования формату, полезно внедрить few-shot prompting, предоставляя модели несколько пар «вход → желаемый выход» для демонстрации паттерна. Температура генерации должна оставаться низкой (от 0.0 до 0.2) при работе с кодом или фактологическими данными, чтобы минимизировать вариативность.
Ограничением подхода является необходимость вручную управлять историей диалога, так как модель не сохраняет состояние между независимыми HTTP-запросами без явной передачи контекста. Для производственных сценариев это означает, что приложение обязано аккумулировать историю сообщений и передавать полный массив при каждом обращении к API.
Типичные ошибки промптов: Отрицания вместо инструкций и игнорирование галлюцинаций
Запреты вроде «не пиши длинно» игнорируют механику токенизации, уступая прямым лимитам в 80 слов. Модели оперируют вероятностями продолжения текста, поэтому негативные инструкции часто воспринимаются как описание нежелательного контекста, а не команда его избегания. Конструктивные указания задают четкую траекторию генерации, снижая когнитивную нагрузку на алгоритм. Отсутствие явного требования опираться только на предоставленные данные провоцирует галлюцинации, когда модель заполняет пробелы выдуманными фактами. Инженерам следует явно прописывать ограничение: если информации нет, необходимо сообщить об этом, а не синтезировать ответы.
Таблица показывает разницу между ошибочными и эффективными формулировками:
| Ошибочный паттерн | Эффективная замена |
| Отрицание действия | Позитивная инструкция |
| Размытый контекст | Явные входные данные |
| Надежда на телепатию | Полный набор фактов |
Фактологические задачи требуют снижения температуры до минимальных значений, что минимизирует творческий разброс. Неудовлетворительный результат генерации почти всегда кроется в дефектной постановке задачи, а не в ограничениях самой модели. Промышленное использование требует отказа от надежды на угадывание intent в пользу жесткой спецификации. Только структурный подход превращает LLM из генератора шума в предсказуемый инструмент.
About
Marcus Chen serves as Lead Agent Engineer at AI Agents News, where he architects and evaluates production-grade multi-agent systems daily. His deep immersion in agent orchestration frameworks like CrewAI, AutoGen, and LangGraph positions him uniquely to dissect the mechanics of effective prompting. While many users treat prompts as simple queries, Chen's work requires constructing precise, context-rich instructions that enable autonomous agents to execute complex tool use and function calling reliably. This article translates his engineering rigor into practical guidance, demonstrating how structured prompt design, defining roles, constraints, and output formats, directly impacts agent performance and stability. At AI Agents News, we focus on empowering builders with factual, technical insights rather than hype. By understanding the underlying logic of how models process instructions, engineers can build more reliable agentic workflows. Chen's analysis bridges the gap between theoretical prompt engineering and the real-world demands of deploying dependable AI agents in software production environments.
Conclusion
Prompt quality is a specification problem rather than a wording one. The five blocks decide what the model can and cannot do: role, format and constraints stay fixed in the system message while context and task change per request, and a prohibition such as "do not write long" is read as a description of unwanted context rather than as a command, which is why a direct limit of 80 words holds where the negation fails.
The price is tokens. Few-shot examples and step-by-step reasoning both inflate context and output, and the model keeps no state between independent API calls, so the application has to carry the history itself. Keep temperature between 0.0 and 0.2 for code and factual work, spend examples only where the output format has to be guaranteed, and read a bad answer as a defect in the assignment rather than a limit of the model.
Frequently Asked Questions
A vague query gives the model no trajectory, so the algorithm fills the gaps with generic templates. Rewriting the request as a positive instruction with a stated limit works where a prohibition does not, because the model reads a prohibition as a description of unwanted context rather than as a command.
Effective prompts require role, context, task, format, and constraints to function correctly. This five block architecture eliminates guesswork and ensures the model generates stable output immediately.
It shifts probability distributions toward desired answers using specific instructions rather than magic phrases. This discipline extends model capabilities for specific tasks without requiring retraining of the system.
Use examples when the output format has to be guaranteed and plain instructions fail to hold it. The boundary is budget: every pair enlarges the context and the latency, so under tight cost or latency targets a strict format block without examples is the cheaper trade.
The model will invent facts to fill gaps since it only sees provided text. Missing context forces the algorithm to rely on general templates instead of your specific data.
References
